Trả lời nhanh: Một nền tảng thi trực tuyến chống gian lận cần 4 lớp: (1) ngân hàng câu hỏi gắn nhãn và ma trận đề; (2) sinh đề riêng cho từng thí sinh; (3) phiên thi do server kiểm soát, đáp án và đồng hồ không rời server; (4) phân tích sau thi để gắn cờ bất thường cho con người xem xét. Camera giám sát chỉ là lớp bổ sung.
Khi nói đến chống gian lận thi trực tuyến, nhiều người nghĩ ngay đến camera, khóa trình duyệt hoặc AI giám sát. Những công cụ đó có ích, nhưng chúng là lớp phòng vệ cuối cùng, không phải đầu tiên.
Phần lớn gian lận trở nên vô nghĩa ngay từ khi thiết kế đề: nếu hai thí sinh ngồi cạnh nhau nhận hai đề khác nhau, chép bài không còn tác dụng. Nếu đáp án không bao giờ được gửi xuống trình duyệt, không ai “bắt” được nó bằng công cụ lập trình viên.
Bài này mô tả kiến trúc 4 lớp mà XO dùng khi thiết kế nền tảng thi trực tuyến: ngân hàng câu hỏi → sinh đề theo thí sinh → phiên thi do server kiểm soát → phân tích sau thi. Mỗi lớp chặn một nhóm hành vi khác nhau, và không lớp nào đủ mạnh khi đứng một mình.
Thí sinh có thể gian lận thi trực tuyến bằng cách nào?
Trước khi chọn giải pháp, hãy liệt kê thí sinh có thể gian lận bằng cách nào. Mỗi kiểu cần một lớp phòng vệ khác nhau:
| Kiểu gian lận | Ví dụ | Lớp chặn chính |
|---|---|---|
| Chép bài giữa thí sinh | Gửi đáp án qua chat, nhóm làm chung | Lớp 2: mỗi người một đề |
| Lộ đề | Chụp màn hình, đề lưu hành qua các đợt thi | Lớp 1: ngân hàng đủ lớn, kiểm soát độ phơi nhiễm câu hỏi |
| Can thiệp kỹ thuật | Đọc đáp án trong mã trang, sửa đồng hồ, gửi lại request | Lớp 3: server giữ đáp án và thời gian |
| Tra cứu, hỏi AI trong giờ thi | Mở tab khác, dùng điện thoại | Lớp 1 (câu hỏi vận dụng) + Lớp 4 (tín hiệu) |
| Thi hộ | Người khác đăng nhập làm bài | Xác thực danh tính, giám sát (proctoring) |
Bảng này cho thấy một điều quan trọng: camera chỉ giải quyết rõ ràng dòng cuối. Bốn dòng còn lại được xử lý tốt hơn bằng thiết kế hệ thống.
Lớp 1: Ngân hàng câu hỏi và ma trận đề
Không thể trộn đề nếu không có gì để trộn. Nền móng của mọi hệ thống chống gian lận là một ngân hàng câu hỏi có cấu trúc.
Mỗi câu hỏi cần được gắn nhãn ít nhất theo: chủ đề, kỹ năng, mức độ nhận thức (nhận biết, thông hiểu, vận dụng…) và độ khó. Độ khó ban đầu do giáo viên ước lượng, sau đó được hiệu chỉnh bằng dữ liệu làm bài thực tế.
Ma trận đề (blueprint) quy định một đề cần bao nhiêu câu mỗi loại. Ví dụ: 40 câu, trong đó 12 câu Hàm số (4 nhận biết, 5 thông hiểu, 3 vận dụng), 10 câu Hình học… Đề thi không còn là một danh sách câu cố định, mà là một công thức.
Từ đó có hai nguyên tắc:
- Mỗi ô trong ma trận cần nhiều câu tương đương. Nếu ô “Hàm số – vận dụng” chỉ có 3 câu mà đề cần 3, mọi thí sinh sẽ nhận cùng 3 câu đó.
- Kiểm soát độ phơi nhiễm. Đếm số lần mỗi câu đã xuất hiện và giới hạn những câu bị dùng quá nhiều. Trong đo lường giáo dục, đây là bài toán item exposure control, với phương pháp kinh điển của Sympson và Hetter (1985): đặt mức phơi nhiễm tối đa cho từng câu để hệ thống không dùng lặp đi lặp lại một số câu.
Một lựa chọn quan trọng khác: tách kho luyện tập và kho đánh giá. TopThi dùng hai ngân hàng riêng, để bài kiểm tra định kỳ luôn gồm những câu học sinh chưa gặp khi luyện. Kết quả đo được năng lực thật, không phải trí nhớ đáp án.
Với nguy cơ tra cứu và hỏi AI trong giờ thi, XO ưu tiên câu hỏi vận dụng vào tình huống mới, có giới hạn thời gian hợp lý, thay vì câu hỏi nhớ định nghĩa.
Lớp 2: Mỗi thí sinh một đề
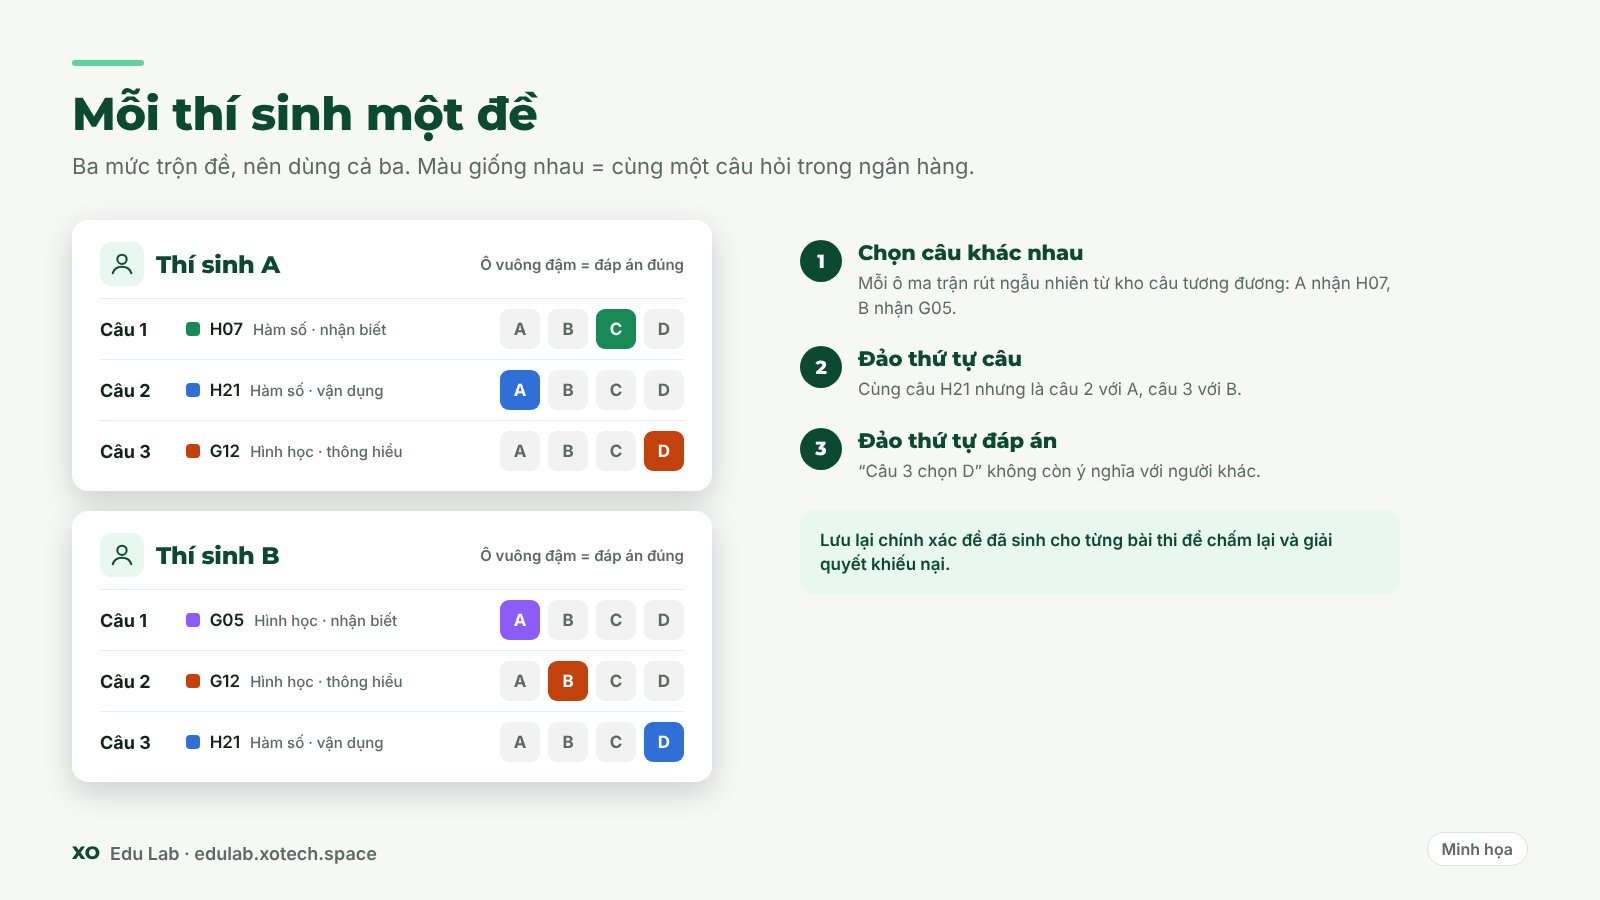
Khi đã có ngân hàng và ma trận, hệ thống có thể sinh đề riêng cho từng người. Có ba mức trộn, nên dùng cả ba:
- Chọn câu khác nhau: mỗi ô trong ma trận rút ngẫu nhiên từ kho câu tương đương.
- Đảo thứ tự câu: hai thí sinh cùng nhận một câu cũng gặp nó ở vị trí khác nhau.
- Đảo thứ tự đáp án: “Câu 5 chọn B” không còn ý nghĩa với người khác. Lưu ý đánh dấu những câu không được đảo, ví dụ câu có đáp án “Cả A và B đều đúng”.
Một mức nâng cao hơn là câu hỏi có tham số: cùng một mẫu nhưng số liệu được sinh khác nhau cho mỗi người. Cách này rất hiệu quả với Toán, Lý, Hóa, nhưng cần kiểm tra kỹ để các biến thể có độ khó như nhau.
Về kỹ thuật, có hai điểm dễ bị bỏ qua:
- Lưu lại đề đã sinh. Mỗi bài thi cần lưu chính xác đề mà thí sinh đã nhận (danh sách câu, thứ tự, thứ tự đáp án, hoặc seed sinh ngẫu nhiên). Thiếu cái này thì không thể chấm lại hay giải quyết khiếu nại.
- Công bằng giữa các đề. Đề của mọi người phải tương đương về nội dung và độ khó. Đây là lý do ma trận và nhãn độ khó ở Lớp 1 quan trọng: trộn ngẫu nhiên hoàn toàn có thể tạo ra một đề dễ hơn hẳn đề khác.
Lớp 3: Phiên thi do server kiểm soát
Nguyên tắc của lớp này: không tin bất cứ điều gì trình duyệt gửi lên. Bản hướng dẫn bảo mật logic nghiệp vụ của OWASP viết: trạng thái phía client là đầu vào, không phải sự thật; mọi giá trị liên quan đến bảo mật phải được server tự tính lại; một bước đã hoàn tất thì mọi lần gửi lại phải bị từ chối. Áp vào thi trực tuyến:
- Đáp án không rời khỏi server. Trình duyệt chỉ nhận nội dung câu hỏi và các lựa chọn. Việc chấm điểm diễn ra trên server, sau khi nộp.
- Đồng hồ nằm trên server. Thời điểm bắt đầu và hạn nộp được lưu trên server. Đồng hồ trên màn hình chỉ để hiển thị; câu trả lời đến sau hạn sẽ bị từ chối dù máy thí sinh báo gì.
- Mỗi phiên thi có một token riêng. Câu trả lời phải đi kèm token hợp lệ; request gửi lại hay giả mạo bị loại.
- Giới hạn một phiên một thiết bị. Mở bài thi ở thiết bị thứ hai thì phiên đầu bị khóa hoặc cần giám thị xác nhận.
- Lưu tự động từng câu. Mất mạng không được làm mất bài. Đây vừa là trải nghiệm, vừa là chống gian lận: nếu hệ thống hay lỗi, “máy em bị lỗi” sẽ trở thành lý do xin thi lại.
Nếu đáp án được gửi xuống trình duyệt để “chấm cho nhanh”, bất kỳ ai biết mở công cụ lập trình viên (F12) đều có thể đọc được.
Lớp 4: Tín hiệu bất thường và phân tích sau thi
Ba lớp đầu ngăn gian lận xảy ra. Lớp thứ tư giúp phát hiện những gì vẫn lọt qua.
Trong giờ thi, hệ thống ghi lại các sự kiện như rời khỏi tab, thoát chế độ toàn màn hình, dán văn bản vào ô trả lời, mất kết nối bất thường.
Sau khi thi, dữ liệu làm bài cho thấy những mẫu khó giải thích:
- Hai thí sinh trùng nhau bất thường ở các câu trả lời sai. ETS, tổ chức vận hành kỳ thi SAT, dùng chỉ số K để đo mức trùng bất thường giữa các câu trả lời sai của hai thí sinh (Holland, 1996).
- Trả lời đúng câu khó trong vài giây, nhưng sai câu dễ.
- Kết quả bài thi chênh lệch rất xa so với lịch sử luyện tập của chính người đó.
- Một câu hỏi đột nhiên có tỷ lệ đúng tăng vọt so với các đợt trước, có thể là dấu hiệu câu đó đã bị lộ.
Điều quan trọng nhất: đây là tín hiệu để con người xem xét, không phải bằng chứng để hệ thống tự kết luận. Rời tab có thể do thông báo bật lên. Làm nhanh có thể vì học sinh giỏi. Hệ thống nên gắn cờ và đưa cho giám thị, kèm đủ bối cảnh để họ quyết định.
Dữ liệu này còn có giá trị ngoài chống gian lận: nó cho biết câu nào quá dễ, câu nào gây hiểu nhầm, câu nào cần viết lại. Ngân hàng câu hỏi tốt lên sau mỗi đợt thi.
Toàn cảnh kiến trúc chống gian lận
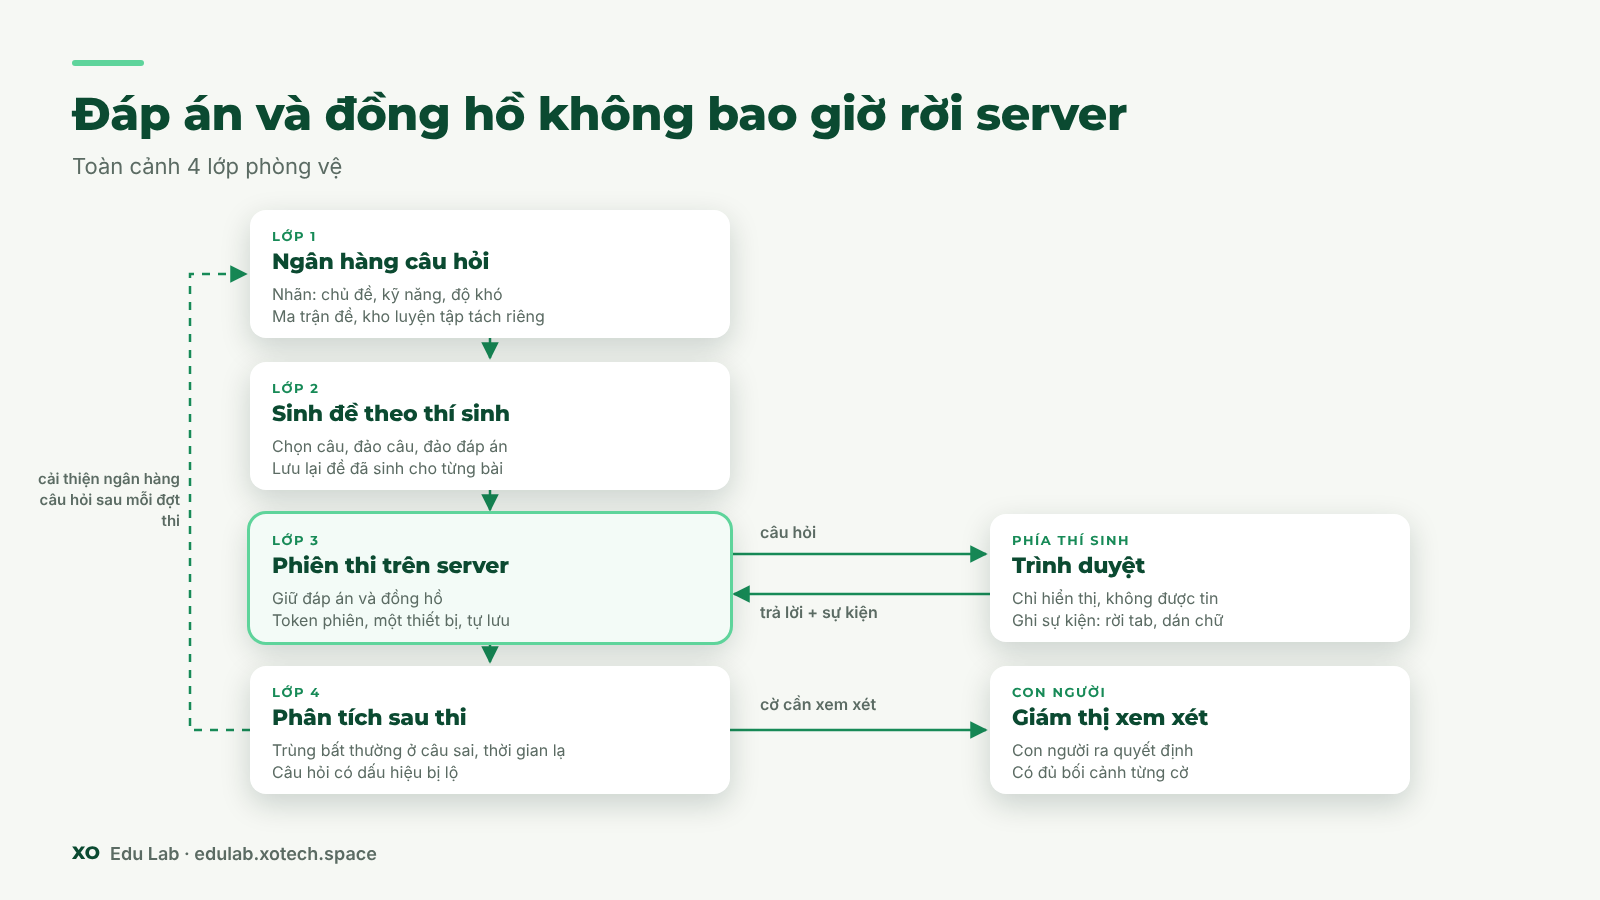
Trình duyệt chỉ nhận câu hỏi và gửi lại câu trả lời. Mọi quyết định quan trọng nằm trên server, và dữ liệu sau mỗi đợt thi quay lại làm ngân hàng câu hỏi tốt hơn.
Những điều kiến trúc không giải quyết được
Không có hệ thống thi trực tuyến nào chống gian lận tuyệt đối. Mục tiêu thực tế là làm cho gian lận khó, tốn công và dễ bị phát hiện hơn lợi ích nó mang lại. Ba trade-off cần cân nhắc:
- Mức độ kiểm soát phải tương xứng với độ quan trọng. Một bài kiểm tra 15 phút trên lớp không cần camera và khóa trình duyệt. Một kỳ thi cấp chứng chỉ thì có thể cần.
- Quyền riêng tư. Ghi hình, ghi màn hình, thu thập dữ liệu thiết bị đều là xử lý dữ liệu cá nhân. Tại Việt Nam, việc này chịu điều chỉnh của Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15, có hiệu lực từ 01/01/2026. Với trẻ em, quyền của chủ thể dữ liệu do người đại diện theo pháp luật thực hiện (Điều 24). Dữ liệu sinh trắc học có yêu cầu bảo vệ riêng (Điều 31).
- Công bằng với thí sinh có điều kiện kém. Mạng chập chờn, máy cũ, không có webcam — hệ thống không nên mặc định coi đó là gian lận.
Cách đánh giá cũng ảnh hưởng đến động cơ gian lận. Nghiên cứu của Daumiller và Janke (2019) trên tạp chí AERA Open cho thấy người học gian lận nhiều hơn khi được thúc đẩy để tỏ ra giỏi và kết quả chỉ được chấm theo đầu ra, thay vì theo cách họ làm. Chống gian lận vì vậy không chỉ là bài toán kỹ thuật, mà còn là bài toán thiết kế đánh giá.
Câu hỏi thường gặp
Trộn đề ngẫu nhiên có đủ để chống gian lận không?
Không. Trộn đề chỉ chặn việc chép bài giữa thí sinh. Nó cần một ngân hàng câu hỏi đủ lớn, phiên thi do server kiểm soát và phân tích sau thi để chặn lộ đề và can thiệp kỹ thuật.
Thi trực tuyến có cần camera giám sát không?
Tùy mức độ quan trọng của bài thi. Bài kiểm tra ngắn trên lớp thường không cần; kỳ thi cấp chứng chỉ thì có thể cần. Ghi hình thí sinh là xử lý dữ liệu cá nhân, chịu điều chỉnh của Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15.
Vì sao không nên chấm điểm trên trình duyệt?
Nếu đáp án được gửi xuống trình duyệt, bất kỳ ai biết mở công cụ lập trình viên (F12) đều có thể đọc được. Hướng dẫn của OWASP yêu cầu mọi giá trị liên quan đến bảo mật phải được server tự tính lại.
Làm sao phát hiện chép bài sau khi thi?
Tìm các mẫu khó giải thích: hai thí sinh trùng nhau bất thường ở các câu sai (ETS dùng chỉ số K cho việc này), trả lời đúng câu khó quá nhanh, hoặc kết quả lệch xa lịch sử luyện tập. Đây là tín hiệu để con người xem xét, không phải bằng chứng để hệ thống tự kết luận.
Điều đáng nhớ
Chống gian lận tốt nhất là làm cho gian lận không còn tác dụng: mỗi người một đề, đáp án không rời server, và dữ liệu sau thi giúp con người ra quyết định. Camera chỉ là lớp cuối cùng.